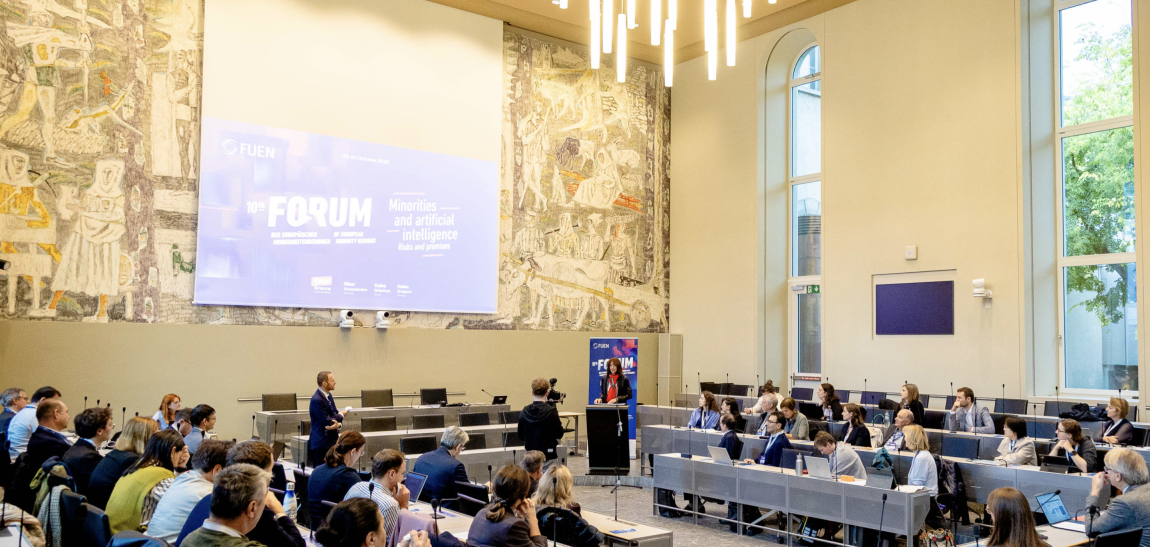
Réunis les 23 et 24 octobre 2026 à Coire, en Suisse, à l'occasion du 10e Forum des régions européennes de minorités organisé par la FUEN, des représentants de minorités linguistiques, des chercheurs et des entreprises technologiques ont présenté les possibilités offertes par l'intelligence artificielle pour préserver et développer leurs langues. Du romanche à l'irlandais, en passant par le ladin, les initiatives se multiplient. Des expériences qui pourraient également inspirer l'avenir numérique du breton.
En ouverture, sa présidente Olivia Schubert a rappelé que la diversité linguistique devait être prise en compte dans les politiques européennes sur l'intelligence artificielle. La FUEN demande notamment que les langues minoritaires soient intégrées aux politiques numériques des États et que leurs communautés participent aux décisions qui les concernent.
Selon Marius Lukosiunas, représentant de l'UNESCO, sur les quelque 7 000 langues parlées dans le monde, seulement 1 000 seraient représentées sur Internet. Pour Martin Bühler, président du gouvernement des Grisons, lorsqu'un outil numérique fonctionne mieux dans une langue dominante, il encourage progressivement les utilisateurs à délaisser leur propre langue.
Le romanche développe ses propres outils numériques
L'organisation Lia Rumantscha a présenté plusieurs réalisations, notamment ClaviRom, un clavier Android adapté au romanche, et ALAS, un système de traduction automatique qui a effectué plus de 460 000 traductions en 178 jours. Ces initiatives illustrent le concept de « souveraineté numérique linguistique » : permettre aux communautés de conserver la maîtrise de leurs ressources linguistiques et des technologies qui les exploitent.
L'irlandais mise sur les technologies vocales
L'Irlande a présenté sa stratégie d'intégration de la langue irlandaise dans les services publics numériques. Neasa Ní Chiaráin a notamment exposé les travaux du projet public ABAIR, consacré à la reconnaissance automatique de la parole et à la synthèse vocale en irlandais. La maîtrise des données linguistiques par les communautés constitue également une priorité.
Le ladin entre dans les smartphones
Le ladin, langue romane parlée notamment dans les Dolomites, bénéficie de plusieurs innovations. Samuel Frontull, chercheur à l'université d'Innsbruck et à l'Institut ladin, a présenté Tradutur, un système de traduction automatique, ainsi que des outils d'intelligence artificielle fonctionnant directement sur les appareils des utilisateurs.
Les entreprises Lenovo et Motorola ont participé à la localisation de plus de 200 000 mots pour une interface de smartphone en ladin. Cette collaboration a également permis de développer LiLa, un modèle de traduction automatique à code ouvert.
En Roumanie, dans le Pays sicule, une équipe développe un assistant conversationnel destiné à aider les locuteurs hongrois dans leurs démarches administratives.
Google présente ses modèles ouverts
Daan van Esch, représentant de Google, a indiqué que les claviers pour smartphones de l'entreprise prennent en charge environ 900 variétés linguistiques. Il a également présenté Gemma, une famille de modèles d'intelligence artificielle à poids ouverts que les chercheurs peuvent adapter à leurs propres corpus linguistiques. Cette approche permet d'envisager des modèles spécialisés dans les langues minoritaires sans devoir développer une intelligence artificielle entièrement à partir de zéro.
Et le breton ?
Les expériences présentées en Suisse trouvent un écho particulier en Bretagne. Plusieurs outils numériques existent déjà pour le breton, notamment Anaouder, un système de reconnaissance vocale permettant de transcrire automatiquement des enregistrements audio et vidéo.
Mais les grands modèles de langage ouvrent d'autres perspectives : assistants conversationnels capables de répondre en breton, traduction contextualisée, outils pédagogiques ou encore recherche documentaire dans des corpus bretons.
Le défi concerne autant la constitution de corpus de qualité que la prise en compte des mutations grammaticales, des variantes dialectales et l'évaluation des résultats par des bretonnants compétents.
Le Pays basque développe son propre modèle de langage
Les projets basques n'étaient pas présentés au colloque. Latxa est un grand modèle de langage (LLM) développé pour le basque par le centre de recherche HiTZ de l'Université du Pays basque. Adapté à partir de modèles ouverts de la famille Llama (Facebook) et entraîné sur un corpus représentant 4,2 milliards de tokens (unités de texte utilisées par les modèles d'IA), Latxa ne se limite pas à la traduction automatique : il vise à comprendre des instructions, produire des textes et dialoguer en euskara.
Rien sur nous sans nous »
En conclusion du forum, le vice-président de la FUEN, Sterică Fudulea, a rappelé le principe : « Rien sur nous sans nous ».
L'intelligence artificielle peut accélérer l'uniformisation linguistique, mais aussi contribuer à revitaliser les langues minoritaires, à condition que leurs locuteurs participent directement au développement des technologies qui les concernent.
Sources :
FUEN, compte rendu du 10e Forum des régions européennes de minorités, 26 octobre 2026 ;
Centre de recherche HiTZ, projet Latxa.

evezhiadennoù (11)
Car le problème, c'est le faible corpus de données en ligne, ou de productions écrites et orales enregistrées/conservées tout court. L'IA est efficace quand le corpus de données est suffisamment étendu, permettant un tri qui la rend fiable.
En breton, c'est l'intention du locuteur qui sous-tend la structure de la phrase. C'est le locuteur qui décide ce qui est important, de son point de vue à lui. Et c’est en conséquence du point présenté comme important que le locuteur construit sa phrase, syntaxiquement parlant.
En conversation courante, il peut arriver aussi que le locuteur réponde à une question posée par un tiers. Pelec’h ? Pegoulz ? Penaos ? Perak ?, ha kement zo. Où ? Quand ? Comment ? Pourquoi ? etc. En s’exprimant ainsi, le questionneur indique ce qui lui importe. Et la réponse sera construite en fonction de cette attente.
Dans tous les cas, l’IA ne peut pas décider quels sont les centres d’intérêts ou les priorités de celui qui parle. Priorités qui sont révélées par la syntaxe même de la phrase, énoncée dans l’instant. Il faut noter que cette particularité (certains disent, avec raison, cette souplesse) est spécifique du breton (au moins par rapport au français).
L’IA ne peut et ne pourra jamais décider à la place du locuteur. Bien évidemment.
Que constatons-nous ? Trop souvent, et très malheureusement, l’IA se borne à structurer ainsi la phrase : sujet/verbe/complément(s). Cela s’appelle transcoder du français en breton. Il en résulte quelque chose qui, en première approximation, ressemble à du breton. Mais très rapidement, cela devient fadasse et procure une sorte de mal de mer, soulève le cœur presque jusqu’au dégoût. Cela a vaguement la couleur du breton – si l’on est indulgent – mais cela n’en est pas !
Voilà le défi - et il n’est pas mince - posé par le breton à l’IA. Comment faire ? J’avoue qu’à ce stade, je n’en sais rien. Peut-être les choses se décanteront-elles dans le futur ? Et je serais curieux de savoir ce qu’en pensent les développeurs et autres spécialistes des systèmes informatiques d’aujourd’hui.
J’en profite pour évoquer un point de sémantique :
Naouegezh artifisiel ? Naouegezh galvezel ? Intent artifisiel (IA) ?
Le français n’a pas cherché à créer un nouveau mot – et c’est dommage ! Il l’avait pourtant fait, dans les années soixante, avec « informatique » inventé et proposé face à « data processing ». Cette fois-ci, le français – perte de vigueur culturelle ? – s’est contenté d’emprunter paresseusement à l’américain (« intelligence » assorti du qualificatif « artificiel »). Or, dans ces deux mots (« intelligence artificielle »), aucun à mon sens ne convient.
Du côté du breton, il existe au moins deux écoles qui proposent chacune leur vocable (« Naouegezh » / « Intent »). Quant au qualificatif, il est simplement transcodé du français ou de l’américain, ce qui donne, en graphie bretonne, « artifisiel ». Il y a aussi une proposition différente « kalvezel », insistant sur l’idée de sculpture ou de façonnage. Ce qui donnerait « Naouegezh galvezel » (expression utilisée par Emile Granville).
En y réfléchissant, je trouve que l’adjectif « niverel » (numérique) aurait l’avantage d’évoquer la machinerie informatique. Ou alors, plus audacieux, « dizenel » (di+denel) qui signale que l’on s’écarte de l’origine humaine (une « intelligence », dans l
Ce n'est pas l'IA qui est en cause, mais plutôt la pauvreté quantitative et qualitative de la production bretonnante disponible dans les bases de données qui font que l'IA ne peut pas être entraînée correctement... et il est également tout à fait possible que, pour pallier des trous béants, l'IA colmate en se basant sur le fonctionnement du français.
Je note qu'il n'y a que deux commentaires sur cet article tout à fait intéressant et sur un sujet de très grande importance, c'est triste.
La civilisation celtique a disparu de son manque d'organisation et d'unité et d'un savoir qui en est resté au stade de l'oralité, confisqué par une forme de lobby druidique. L'IA, c'est une sorte de réinvention de l'écriture ou de l'imprimerie. Il ne faut pas passer à côté.
Dans 10 ans, il n'y aura plus que 3 langues véhiculaires ? ... et peut-être pas le français.
+ des étés à 40 ou 45 ° à Brest car les data centers sont des gouffres à énergie, réchauffent et empoisonnent l'air.
Le suffixe « egezh » est la marque d’une qualité générale et concrète. Cela ne traduit donc pas l’action, la pratique. Pour cela, il faut prendre le suffixe « erezh ». Donc « naouerezh » serait préférable. Je propose en plus de mettre en préfixe le mot « ijin », terme général qui correspond aux notions suivantes : génie, imagination, artifice, art, science, machine. Je propose donc au final pour IA : « ijinnaou », c'est-à-dire « connaissance par la machine ». Ce qui permet d’utiliser un verbe « ijinnaouiñ » (pratiquer l’IA), des substantifs comme « ijinnaouerezh » (la pratique, les activités de l’IA), « ijinnaouer » (le praticien de l’IA) et « ijinaouerez » au féminin. Ainsi, on pourrait disposer d’un seul mot « ijinnaou » au lieu d’un substantif plus un adjectif, facile à prononcer, duquel il est possible de faire dériver tous les autres mots nécessaires à la pratique de l’IA.
.../..
En y réfléchissant, je trouve que l’adjectif « niverel » (numérique) aurait l’avantage d’évoquer la machinerie informatique. Ou alors, plus audacieux, « dizenel » (di+denel) qui signale que l’on s’écarte de l’origine humaine (une « intelligence », dans l’ordre de la machine, que l’on ne saurait confondre avec l’intelligence « humaine », donc). En discutant de cela, au salon du livre de Karaez, sur le stand d’Al Liamm, j’ai constaté que cette idée était mal reçue.
Ha c’hwi ? Petra eo ho soñj war ar poent-se ?
En français, on peut faire des faux, mais pas en breton.
L'imprimerie a par exemple permis de sanctuariser et de cadrer de nombreuses langues « vulgaires » (au dépend d'autres également...).
Si les meilleurs linguistes bretons se coordonnent pour orienter les moteurs IA vers des traductions de qualité, fiables, c'est une opportunité unique.
Dénigrons la technologie moderne et son potentiel, et notre place de bretonnants sera dans les oubliettes de l'histoire.